
注目ポイント
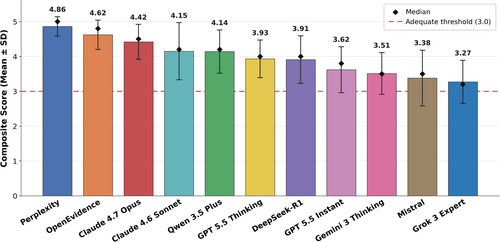
この盲検化された専門医評価研究では、標準化された合成歯周病臨床ビネットを用いて、一般用途の大規模言語モデル(Large Language Models, LLMs)9種と検索拡張型プラットフォーム2種を含む11のAIシステムを比較した。検索拡張型システム、特に Perplexity と OpenEvidence は、正確性および安全性の指標において一般用途の LLM を上回った。平均スコアは有望であったものの、AI生成回答のうち相当数に潜在的に危険な情報が含まれており、専門医の判断を代替するものではなく、補助ツールとして慎重に臨床使用すべきであることが示された。
研究背景
歯周病は、その慢性経過、全身疾患との関連、ならびに口腔健康関連QOLへの影響により、世界的に重要な公衆衛生上の課題となっている。正確な診断と管理は複雑な臨床評価に依存しており、高度な意思決定支援ツールの恩恵を受ける可能性がある。人工知能(Artificial Intelligence, AI)、とくに大規模言語モデル(Large Language Models, LLMs)および検索拡張型プラットフォームは、知識の統合と臨床推論の支援を通じて医療分野で有望性を示してきた。しかし、歯周病領域におけるこれらのAIシステムの比較評価はなお限られている。本研究は、将来的な臨床導入に資するため、歯周病の診断および管理に特化してAIの正確性、安全性、信頼性を評価するという重要な必要性に応えるものである。
研究デザイン
本研究は、盲検化されたランダム化ブロックデザインを用いて、9種の一般用途LLM(例:Claude 4.7 Opus)、1種の一般用途検索拡張型プラットフォーム(Perplexity)、および1種の医療分野向け検索拡張型プラットフォーム(OpenEvidence)から成る11のAIシステムを評価した。急性、慢性、複雑な病態を含む多様なシナリオを表現した30件の標準化された合成歯周病臨床ビネットを各AIに提示し、回答を生成させた。回答は、検証済みの5段階Likert尺度を用いて、盲検化された6名の歯周病専門医が独立して採点した。評価項目は、情報の正確性、安全性(有害な推奨がないこと)、ハルシネーション(不正確または捏造された内容)の欠如、ならびに回答の完全性の4領域であった。
統計解析には、Friedman検定およびConover–Iman検定にHolm補正を組み合わせた多重比較を用い、感度分析として混合効果モデルおよび順序尺度モデルを補助的に実施した。本研究は、AIプラットフォーム間の性能指標の差異を明らかにし、臨床応用性が最適なシステムを特定することを目的とした。
主な結果
全体として、AIシステムの平均総合スコアは5点満点中3.28〜4.86であり、基準値である3.0を上回っていたことから、概ね許容可能な性能を示した。しかし、臨床的に重要な所見として、個々のAI回答の3.3%〜46.7%が「危険」または潜在的に有害なカテゴリ(スコア≤2)に分類され、その割合はプラットフォーム間で異なっていた。このばらつきは、これらのツールを無検証で使用した場合に誤解を招く推奨が提示される現実的なリスクを示している。
統計検定により、AIシステム間で有意な性能差が確認された(p<0.001)。KendallのW係数は全体として小〜中程度の効果量(W=0.17)を示し、システム間の一致度は中等度であった。一方、慢性または複雑な歯周病シナリオなどの下位カテゴリーでは効果量が大幅に大きく(最大W=0.82)、臨床的複雑性に応じて各プラットフォームの能力に明確な差があることが示された。
各プラットフォームの中では、一般用途の検索拡張型システムである Perplexity、医療分野向け検索拡張型プラットフォームである OpenEvidence、ならびにLLMの Claude 4.7 Opus が、すべての評価領域で上位を占め、とくに安全性と正確性で優れていた。検索拡張型システムの相対的に優れた成績は、回答が本質的に長く、より包括的であることによって一部は交絡されている可能性がある。
有望な結果が得られた一方で、安全性スコアの幅の広さとハルシネーションの存在は、厳格な専門家の監督なしに、これらのAIツールを歯周病臨床実践へ無批判かつ一律に導入すべきではないことを示唆している。
専門家コメント
本研究は、症状評価、X線画像の解釈、ならびに精緻な治療計画立案を融合する領域である歯周病の臨床推論に特化して、AIツールをベンチマークした先駆的研究である。盲検化された専門医評価デザインは方法論的に優れており、バイアスを低減するとともに、実臨床における専門医評価を模倣している。検索拡張型システムの組み込みは革新的であり、言語モデルと外部知識ベースを統合するAIの進化を反映して、事実の信頼性を高めているように見える。
しかし、回答の長さが評価に与える影響は方法論上の検討課題を提起する。長い回答はより多くの情報を提供し、完全性や安全性の評価を押し上げる可能性がある一方で、冗長性や不関連な内容を増やし、実臨床での使用性を損なうおそれもある。さらに、合成ビネットは症例提示を標準化できるものの、実際の患者診療に存在する複雑さや予測不能性を完全には反映できず、外的妥当性についてはなお検討の余地が残る。
本結果は、医療AIに関する文献で形成されつつあるコンセンサス、すなわち、これらのシステムは専門医の代替ではなく意思決定支援の補助として用いるべきである、という考えを支持する。広範な導入の前提として、臨床専門知識との緊密な統合、批判的評価、ならびに領域特異的データを用いた継続的なAI訓練が不可欠である。
結論
歯周病の診断および管理を対象とした11のAIプラットフォームの比較評価により、現在のところ検索拡張型システムは、専門医評価による正確性と安全性において一般用途LLMを上回ることが明らかとなった。しかし、危険な回答やハルシネーションを含む応答が少なからず認められたことから、監督のない臨床応用には慎重であるべきである。これらのAIツールは、専門家の判断を代替するものではないが、補助的支援として有望である。今後の研究では、検索拡張手法の改良、出力の簡潔性の最適化、ならびに実臨床環境での性能検証を進め、歯周病学におけるAIの可能性を安全に活用する必要がある。
資金提供および臨床試験
本研究に外部資金提供があったとは示されていない。臨床試験登録の報告はなかった。
参考文献
1. Mayer Y, Demetriou B, Rasperini G, et al. Large Language Models and Retrieval-Augmented Platforms for the Diagnosis and Management of Periodontal Diseases: A Blinded Expert-Rated Comparative Study of 11 Systems. J Clin Periodontol. 2026 Jul;53(10):1546-1556. PMID: 42402252.
2. Tonetti MS, Jepsen S, Jin L, Otomo-Corgel J. Impact of the global burden of periodontal diseases on health, nutrition, and wellbeing of mankind: A call for global action. J Clin Periodontol. 2017 May;44(5):456-462.
3. Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019 Jan;25(1):44-56.
4. Esteva A, Robicquet A, Ramsundar B, et al. A guide to deep learning in healthcare. Nat Med. 2019 Jan;25(1):24-29.