
ハイライト
- ルールベースの computable phenotype と大規模言語モデル(Large Language Model, LLM;ChatGPT 4.1)を用いて、救急外来(Emergency Department, ED)の電子健康記録(Electronic Health Record, EHR)データにおける opioid use disorder(OUD)の同定性能が評価された。
- 両手法はいずれも良好な診断精度を示し、negative predictive value が高く、sensitivity は約80%であった。
- 大規模言語モデルは specificity および positive predictive value が有意に高く、false positive の同定が少ないことが示唆された。
- 救急外来のワークフローへの統合可能性と一般化可能性を確認するためには、多様な臨床環境での前向き検証が必要である。
研究背景
opioid use disorder は、米国における重要な公衆衛生上の危機であり、特に opioid の誤用に関連して大きな罹患率および死亡率を伴う。とりわけ救急外来では、opioid 使用に関連する合併症のために多くの患者が受診する。救急外来において OUD 患者を正確に同定することは、迅速な介入、治療プロトコルの開始、ならびに依存症支援サービスへの連携に不可欠である。しかし、電子健康記録(EHR)を用いた同定は、記載のばらつき、過小コーディング、ならびに物質使用障害診断に対するスティグマのために複雑である。 従来の computable phenotype は、診断コード、処方薬、毒性検査、臨床ノートなどの構造化データ要素を利用するルールベースのアルゴリズムであり、OUD を体系的に同定するために用いられてきた。実用性はあるものの、これらのアルゴリズムは、厳格なルールや不完全なデータ取得のために症例を見逃したり、false positive を生じたりする可能性がある。 ChatGPT のような大規模言語モデル(LLM)は、自然言語処理と深層学習を活用して、自由記載の臨床文書を解釈する。これらのモデルは、構造化コードでは捉えられない微妙な臨床パターンを認識できる可能性がある。本研究では、検証済みのルールベース computable phenotype と比較して、LLM が救急外来ノートにおける OUD 検出を強化し得るかどうかを検討した。研究デザイン
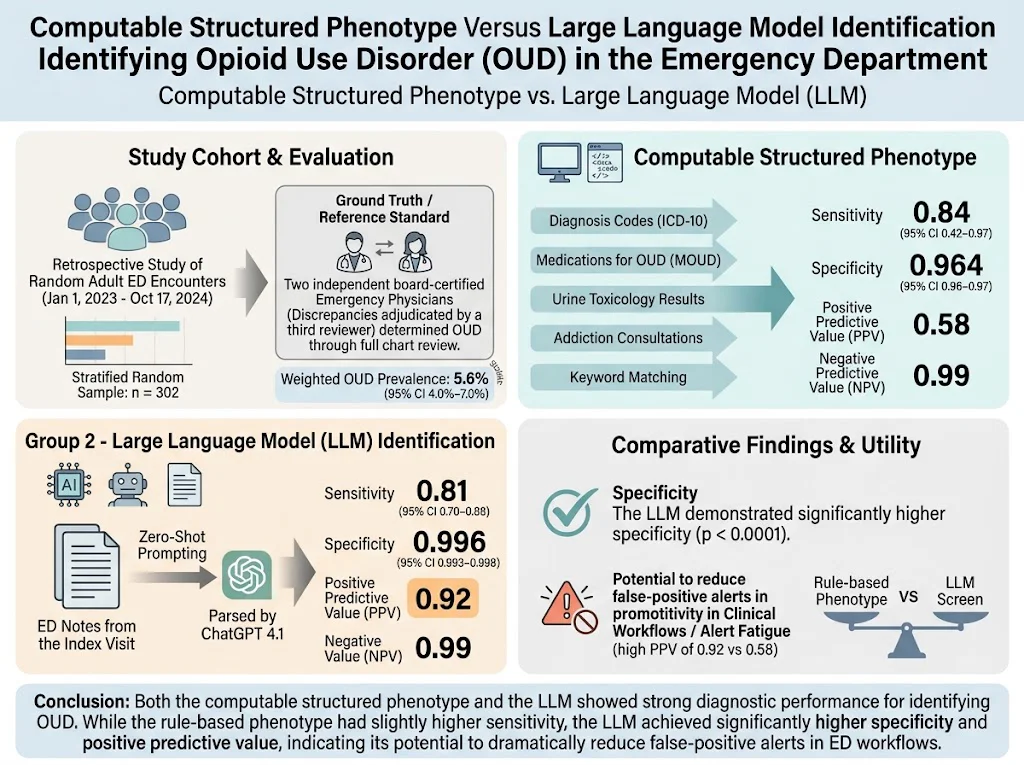
著者らは、単一の学術医療システムにおいて、2023年1月1日から2024年10月17日までの成人救急外来受診を対象とした後ろ向きコホート研究を実施した。OUD に関して確立されたルールベース computable phenotype による事前分類に基づき、層別無作為抽出された302件の受診記録を選定した。この phenotype には、ICD 診断コード、medication-assisted treatment(MAT)に用いられる薬剤の処方、尿中毒物検査結果、依存症医学コンサルト、ならびに臨床ノート内のキーワード検索が含まれていた。 比較対象として、著者らは ChatGPT 4.1 に zero-shot prompting を用い、初回受診時の自由記載救急外来ノートを解析して OUD の有無を分類させた。2名の board-certified emergency physicians が独立して全カルテをレビューし、基準標準とし、相違は3人目のレビューアが解決した。 主要評価項目は、専門家によるカルテレビューを対照とした phenotype および LLM の sensitivity、specificity、positive predictive value(PPV)、negative predictive value(NPV)であった。抽出割合に基づく inverse probability weighting により、罹患率推定値および性能指標が調整された。主要結果
抽出集団における OUD の加重有病率は約 5.6%(95%CI, 4.0~7.0%)であった。構造化 computable phenotype の sensitivity は 0.84(95%CI, 0.42~0.97)、specificity は 0.964(95%CI, 0.96~0.97)であった。PPV は 0.58 と中等度であったが、NPV は 0.99 と高かった。 これに対し、大規模言語モデル(ChatGPT 4.1)の sensitivity は 0.81(95%CI, 0.70~0.88)であり、specificity は 0.996(95%CI, 0.993~0.998)と著しく高かった。この結果、NPV 0.99 を維持しつつ、PPV は 0.92 と大幅に高かった。統計学的検定により、LLM の specificity が有意に優れていることが確認された(P < .0001)。 これらの結果は、ルールベース phenotype は真の症例をやや多く捕捉できる可能性がある一方で(より高い sensitivity)、false positive も多く、PPV を低下させることを示唆する。逆に、LLM の高い specificity は false positive アラートを減少させるため、アラート疲労が臨床判断を妨げ得る救急外来では有利である。専門家コメント
本研究は、臨床現場における物質使用障害の検出に人工知能を活用するうえで重要な前進を示すものである。構造化データと高度な自然言語処理の組み合わせは、症例同定を改善する有望な手段を提供する。 一方で、単施設デザインであること、ならびに後ろ向きカルテレビューに依存していることが限界であり、記載されていない臨床的ニュアンスを捉えられていない可能性がある。また、選定コホートにおける OUD の有病率が比較的低いことも予測値に影響する。さらに、大規模言語モデルの解釈可能性と透明性は依然として課題であり、臨床医の信頼と安全対策が必要である。 今後の研究では、多様な医療システムおよび集団にわたる前向き検証に焦点を当てるべきである。臨床ワークフローへの統合、患者アウトカムへの影響、ならびに費用対効果分析は、実臨床への導入に向けて不可欠である。結論
ルールベースの computable phenotype と大規模言語モデルのいずれも、救急外来の電子健康記録から opioid use disorder を同定するうえで良好な性能を示した。構造化 phenotype は sensitivity でわずかに優れ、一方で大規模言語モデルは specificity と positive predictive value が高く、false positive アラートの減少と臨床的有用性の向上につながる可能性がある。 これらの手法を組み合わせるか、あるいは LLM による一次スクリーニングの後にルールベース確認を行うことで、精度とワークフロー効率を最適化できる可能性がある。進行中の opioid crisis に対処するため、これらのツールを効果的に活用するには、実世界環境でのさらなる検証と評価が必要である。資金提供および ClinicalTrials.gov 登録
公表論文では、資金提供 स्रोतまたは臨床試験登録番号は明記されていなかった。今後の研究では、多施設共同研究および資金提供により、より広範な実装が促進される可能性がある。参考文献
1. Molina MF, Fenton C, LeSaint KT, Pimentel SD, Kohn MA, Kornblith AE. Computable Structured Phenotype Versus Large Language Model Identification of Opioid Use Disorder Using Electronic Health Record Data. Ann Emerg Med. 2026 Jun 13;88(5):562-569. doi:10.1016/j.annemergmed.2026.03.010. PMID: 42287282. 2. Volkow ND, McLellan TA. Opioid Abuse in Chronic Pain — Misconceptions and Mitigation Strategies. N Engl J Med. 2016 Mar 31;374(13):1253-63. doi:10.1056/NEJMra1507771. 3. Beam AL, Kohane IS. Big Data and Machine Learning in Health Care. JAMA. 2018 Apr 3;319(13):1317-1318. doi:10.1001/jama.2017.18391. 4. Kharrazi H, et al. Data quality in electronic health records: a critical appraisal. Yearb Med Inform. 2017 Aug;26(01):127-132. doi:10.15265/IY-2017-015. 5. Rajkomar A, et al. Scalable and accurate deep learning for electronic health records. npj Digital Medicine 1, Article number: 18 (2018). doi:10.1038/s41746-018-0029-1. 6. Sarker A, et al. Machine learning and natural language processing for identifying opioid misuse in electronic health records: a systematic review. J Med Internet Res. 2020 Nov 11;22(11):e18585. doi:10.2196/18585.診療科に関連する計算ツール
計算ツールは英語で表示されます。
臨床上の参考情報です。専門的な判断と併せてご利用ください。