
Điểm nổi bật
Nghiên cứu mù đôi có chấm điểm bởi chuyên gia này đã so sánh 11 hệ thống AI — bao gồm chín mô hình ngôn ngữ lớn đa dụng và hai nền tảng tăng cường truy xuất — bằng các tình huống lâm sàng nha chu tổng hợp, chuẩn hóa. Các hệ thống tăng cường truy xuất, đặc biệt là Perplexity và OpenEvidence, vượt trội hơn các LLM đa dụng về độ chính xác và các chỉ số an toàn. Mặc dù điểm trung bình nhìn chung khả quan, một tỷ lệ đáng lo ngại các phản hồi do AI tạo ra chứa thông tin có khả năng nguy hiểm, cho thấy cần thận trọng khi sử dụng trong lâm sàng, chỉ như công cụ hỗ trợ chứ không phải thay thế phán đoán của chuyên gia.
Bối cảnh nghiên cứu
Bệnh nha chu là một vấn đề y tế công cộng toàn cầu quan trọng do tính chất mạn tính, mối liên quan với các bệnh lý toàn thân và ảnh hưởng đến chất lượng cuộc sống liên quan đến sức khỏe răng miệng. Chẩn đoán và xử trí chính xác phụ thuộc vào đánh giá lâm sàng phức tạp, có thể được hỗ trợ bởi các công cụ hỗ trợ ra quyết định tiên tiến. Trí tuệ nhân tạo (AI), đặc biệt là các mô hình ngôn ngữ lớn (large language models, LLMs) và các nền tảng tăng cường truy xuất, đã cho thấy tiềm năng trong ứng dụng y khoa nhờ khả năng tổng hợp tri thức và hỗ trợ suy luận lâm sàng. Tuy nhiên, đối với bệnh nha chu, các đánh giá so sánh giữa những hệ thống AI này vẫn còn hạn chế. Nghiên cứu này giải quyết nhu cầu cấp thiết trong việc đánh giá độ chính xác, an toàn và độ tin cậy của AI một cách cụ thể trong chẩn đoán và xử trí bệnh nha chu nhằm định hướng tích hợp lâm sàng trong tương lai.
Thiết kế nghiên cứu
Khảo sát được thực hiện theo thiết kế khối ngẫu nhiên có làm mù, đánh giá 11 hệ thống AI gồm chín LLM đa dụng (ví dụ: Claude 4.7 Opus), một nền tảng tăng cường truy xuất đa dụng (Perplexity) và một nền tảng tăng cường truy xuất thuộc lĩnh vực y khoa (OpenEvidence). Ba mươi tình huống lâm sàng nha chu tổng hợp, chuẩn hóa, phản ánh các bối cảnh đa dạng — cấp tính, mạn tính và phức tạp — được trình bày cho từng hệ thống AI để tạo phản hồi. Sáu bác sĩ nha chu chuyên gia, đều được làm mù, chấm điểm độc lập các phản hồi bằng thang Likert 5 mức đã được thẩm định, đánh giá bốn lĩnh vực: độ chính xác của thông tin, an toàn (không có khuyến nghị gây hại), không có hiện tượng “hallucination” (nội dung sai lệch hoặc bịa đặt) và mức độ đầy đủ của câu trả lời.
Các phân tích thống kê bao gồm kiểm định Friedman và Conover–Iman với hiệu chỉnh Holm cho so sánh đa bội, bổ sung bằng mô hình hiệu ứng hỗn hợp và mô hình thứ bậc cho các phân tích độ nhạy. Nghiên cứu nhằm xác định sự khác biệt về các chỉ số hiệu năng giữa các nền tảng AI và nhận diện các hệ thống có tính ứng dụng lâm sàng tối ưu.
Kết quả chính
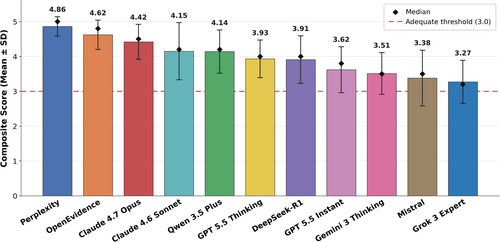
Nhìn chung, các hệ thống AI đạt điểm tổng hợp trung bình từ 3,28 đến 4,86 trên thang 5 điểm, cao hơn mốc trung vị 3,0, cho thấy hiệu năng nói chung là chấp nhận được. Tuy nhiên, một phát hiện đáng chú ý và có ý nghĩa lâm sàng là từ 3,3% đến 46,7% các phản hồi riêng lẻ của AI được xếp vào nhóm “nguy hiểm” hoặc có khả năng gây hại (điểm ≤ 2), thay đổi theo nền tảng. Mức độ biến thiên này cho thấy nguy cơ đáng tin cậy về các khuyến nghị gây hiểu lầm nếu các công cụ này được sử dụng mà không kiểm soát.
Các kiểm định thống kê cho thấy sự khác biệt có ý nghĩa về hiệu năng giữa các hệ thống AI (p < 0,001). Hệ số W của Kendall cho thấy kích thước hiệu ứng tổng thể ở mức nhỏ đến trung bình (W = 0,17), phản ánh mức độ nhất quán vừa phải giữa các hệ thống. Tuy nhiên, trong các phân nhóm như bối cảnh nha chu mạn tính hoặc phức tạp, kích thước hiệu ứng lớn hơn đáng kể (lên tới W = 0,82), nhấn mạnh năng lực khác biệt của từng nền tảng tùy thuộc vào mức độ phức tạp lâm sàng.
Trong số các nền tảng, hệ thống tăng cường truy xuất đa dụng Perplexity, nền tảng tăng cường truy xuất thuộc lĩnh vực y khoa OpenEvidence, và LLM Claude 4.7 Opus nổi lên là những hệ thống có hiệu năng tốt nhất trên tất cả các lĩnh vực, đặc biệt vượt trội về độ an toàn và độ chính xác. Hiệu năng được cho là vượt trội của các hệ thống tăng cường truy xuất một phần chịu ảnh hưởng bởi đặc điểm câu trả lời dài hơn và toàn diện hơn của chúng.
Mặc dù kết quả khả quan, khoảng dao động lớn của điểm an toàn và sự hiện diện của hiện tượng hallucination cảnh báo không nên triển khai các công cụ AI này trong thực hành nha chu lâm sàng một cách thiếu kiểm soát và không phân biệt, nếu không có giám sát chặt chẽ của chuyên gia.
Bình luận chuyên gia
Nghiên cứu này có tính tiên phong khi thiết lập chuẩn so sánh các công cụ AI chuyên biệt cho suy luận lâm sàng trong bệnh nha chu — một lĩnh vực kết hợp đánh giá triệu chứng, diễn giải hình ảnh X-quang và lập kế hoạch điều trị tinh tế. Thiết kế chấm điểm bởi chuyên gia được làm mù là một ưu điểm phương pháp luận, giúp giảm sai lệch và mô phỏng đánh giá của chuyên gia trong thực tế. Việc đưa các hệ thống tăng cường truy xuất vào nghiên cứu là một điểm đổi mới, phản ánh bối cảnh AI đang phát triển, trong đó mô hình ngôn ngữ được kết hợp với các cơ sở tri thức bên ngoài, dường như làm tăng độ tin cậy về mặt तथ्य chính xác.
Tuy nhiên, ảnh hưởng của độ dài câu trả lời lên điểm chất lượng đặt ra một số câu hỏi về phương pháp. Câu trả lời dài hơn có thể cung cấp nhiều thông tin hơn, qua đó làm tăng điểm về mức độ đầy đủ và an toàn, nhưng đồng thời cũng có nguy cơ rườm rà hoặc chứa nội dung không liên quan, làm giảm tính khả dụng trong thực hành lâm sàng. Hơn nữa, mặc dù các tình huống giả lập chuẩn hóa cách trình bày ca bệnh, chúng không thể bao quát toàn bộ mức độ phức tạp hoặc tính khó đoán của các tương tác với người bệnh thực, do đó vẫn còn câu hỏi về giá trị ngoại suy.
Các kết quả này củng cố sự đồng thuận đang hình thành trong y văn về AI trong chăm sóc sức khỏe: các hệ thống này nên đóng vai trò công cụ hỗ trợ ra quyết định chứ không phải thay thế bác sĩ chuyên khoa. Việc tích hợp chặt chẽ với chuyên môn lâm sàng, thẩm định phê bình và có thể huấn luyện AI liên tục trên dữ liệu chuyên biệt theo lĩnh vực là điều thiết yếu trước khi áp dụng rộng rãi.
Kết luận
Đánh giá so sánh 11 nền tảng AI trong chẩn đoán và xử trí bệnh nha chu cho thấy các hệ thống tăng cường truy xuất hiện nay vượt trội hơn các LLM đa dụng về độ chính xác và độ an toàn được chuyên gia chấm điểm. Tuy nhiên, sự hiện diện đáng kể của các phản hồi nguy hiểm hoặc có hiện tượng hallucination cho thấy không nên áp dụng lâm sàng khi chưa có giám sát. Các công cụ AI này có triển vọng như phương tiện hỗ trợ bổ trợ cho phán đoán chuyên khoa, nhưng không phải là sự thay thế. Nghiên cứu tương lai nên cải tiến các phương pháp tăng cường truy xuất, tối ưu hóa độ ngắn gọn của đầu ra và xác thực hiệu năng trong bối cảnh lâm sàng thực tế để khai thác an toàn tiềm năng của AI trong nha chu học.
Tài trợ và thử nghiệm lâm sàng
Nghiên cứu không nêu nhận được nguồn tài trợ bên ngoài. Không có thông tin về đăng ký thử nghiệm lâm sàng.
Tài liệu tham khảo
1. Mayer Y, Demetriou B, Rasperini G, et al. Large Language Models and Retrieval-Augmented Platforms for the Diagnosis and Management of Periodontal Diseases: A Blinded Expert-Rated Comparative Study of 11 Systems. J Clin Periodontol. 2026 Jul;53(10):1546-1556. PMID: 42402252.
2. Tonetti MS, Jepsen S, Jin L, Otomo-Corgel J. Impact of the global burden of periodontal diseases on health, nutrition, and wellbeing of mankind: A call for global action. J Clin Periodontol. 2017 May;44(5):456-462.
3. Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019 Jan;25(1):44-56.
4. Esteva A, Robicquet A, Ramsundar B, et al. A guide to deep learning in healthcare. Nat Med. 2019 Jan;25(1):24-29.