
Bối cảnh nghiên cứu
U nguyên bào giả nhú đặc tụy (Solid pseudopapillary tumor of the pancreas, SPT) là một u hiếm gặp, chủ yếu gặp ở phụ nữ trẻ và nhìn chung có diễn tiến lâm sàng chậm, tiên lượng rất tốt sau phẫu thuật cắt bỏ. Mặc dù hiếm gặp, việc phân tầng tiên lượng vẫn gặp nhiều khó khăn do tỷ lệ tử vong đặc hiệu do ung thư cực kỳ thấp, làm hạn chế giá trị của các mô hình phân tích sống còn truyền thống. Các phương pháp thống kê chuẩn thường không xác định được các phân nhóm có nguy cơ biến cố bất lợi cao do dữ liệu thưa và mất cân bằng lớp. Vì vậy, vẫn còn nhu cầu lâm sàng chưa được đáp ứng đối với các phương pháp đổi mới có khả năng phát hiện những mẫu hình ẩn liên quan đến kiểu hình xâm lấn trong các bệnh tưởng như nguy cơ thấp như SPT.
Thiết kế nghiên cứu
Nghiên cứu hồi cứu này sử dụng dữ liệu từ cơ sở đăng ký Surveillance, Epidemiology, and End Results (SEER), bao gồm các bệnh nhân được cắt tụy vì SPT từ năm 2000 đến năm 2021. Tiêu chí đánh giá chính là tử vong đặc hiệu do ung thư, được xem là một biến cố cực hiếm trong đoàn hệ này. Để khắc phục hạn chế của các mô hình sống còn truyền thống, hai thuật toán phát hiện bất thường không giám sát—Isolation Forest và Local Outlier Factor—được sử dụng để mô hình hóa tính hiếm của tử vong đặc hiệu do ung thư như một bất thường trong không gian đặc trưng lâm sàng – bệnh lý đa chiều.
So sánh thống kê điểm bất thường giữa nhóm bệnh nhân tử vong do SPT và nhóm sống sót được thực hiện bằng kiểm định Mann-Whitney U, với thống kê Cliff’s δ để định lượng kích thước hiệu ứng. Để tăng khả năng diễn giải, mức độ đóng góp của các đặc trưng vào điểm bất thường được ước tính bằng mô hình thay thế Random Forest kết hợp với phương pháp diễn giải SHapley Additive exPlanations (SHAP). Xác thực ngoài được thực hiện trên một đoàn hệ độc lập được tái dựng thông qua tổng quan hệ thống các ca bệnh đã công bố nhằm đánh giá tính khái quát hóa.
Kết quả chính
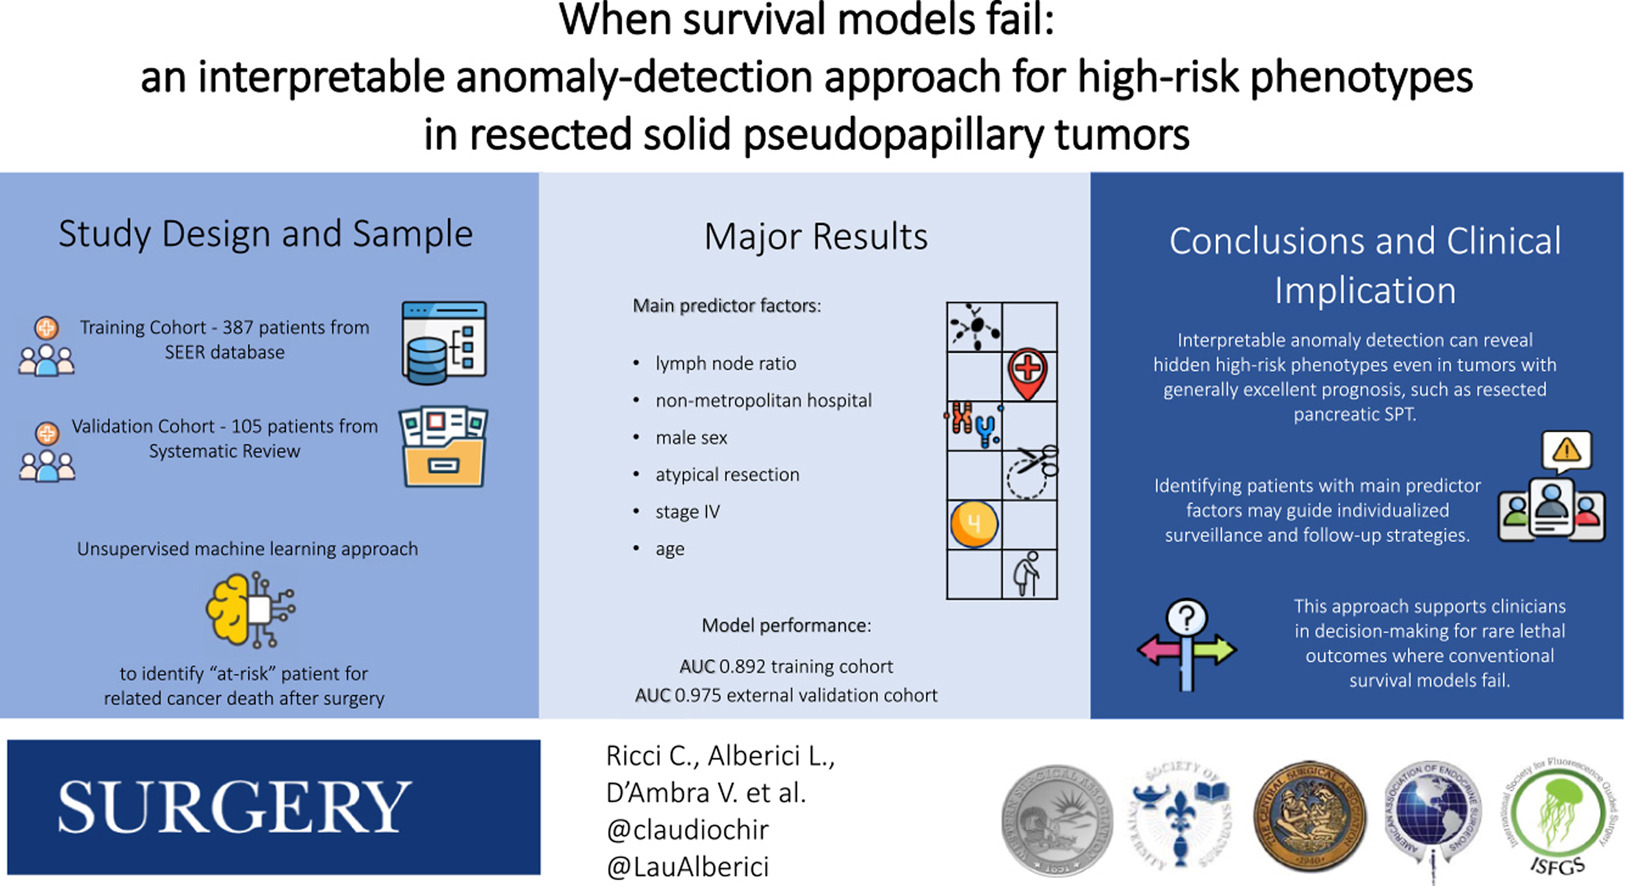
Phân tích 387 bệnh nhân từ cơ sở dữ liệu SEER cho thấy những người cuối cùng tử vong do SPT có điểm bất thường cao hơn có ý nghĩa thống kê, xác nhận hiệu quả của cách tiếp cận phát hiện bất thường trong việc nhận diện kiểu hình nguy cơ cao hiếm gặp (điểm Isolation Forest: -0,07 ± 0,06 so với 0,02 ± 0,05; P = 0,007; Cliff’s δ = 0,783). Các yếu tố đóng góp hàng đầu vào hồ sơ bất thường liên quan đến tử vong theo giá trị SHAP bao gồm:
- Tỷ lệ hạch dương tính (mức đóng góp trung bình 0,204 ± 0,083)
- Loại bệnh viện, đặc biệt là điều trị tại cơ sở ngoài đô thị lớn (0,168 ± 0,037)
- Giới nam (0,130 ± 0,028)
- Các kỹ thuật cắt bỏ không điển hình (0,120 ± 0,028)
- Bệnh giai đoạn IV tại thời điểm chẩn đoán (0,096 ± 0,047)
Mô hình phát hiện bất thường cho thấy hiệu năng dự báo mạnh, với diện tích dưới đường cong ROC (AUROC) trong tập huấn luyện đạt 0,892; AUROC trung bình qua kiểm định chéo là 0,733 ± 0,351; và AUROC xác thực ngoài rất cao là 0,975. Những kết quả này nhấn mạnh khả năng của phương pháp mới trong việc phân biệt các ca nguy cơ cao mặc dù tỷ lệ biến cố tuyệt đối cực kỳ thấp.
Bàn luận chuyên gia
Các mô hình sống còn truyền thống gặp khó khăn khi biến cố thưa và phân bố lớp lệch mạnh, như thường thấy trong tử vong liên quan đến SPT. Việc sử dụng phương pháp phát hiện bất thường đã đổi mới cách nhìn, xem các trường hợp tử vong hiếm do ung thư như các điểm ngoại lai trong không gian đặc trưng lâm sàng – bệnh lý đa chiều thay vì dựa vào mô hình nguy cơ truyền thống. Đáng chú ý, việc tích hợp Random Forest và SHAP cho phép rút ra các nhận định có thể diễn giải trên lâm sàng về các đặc trưng thúc đẩy kiểu hình nguy cơ cao.
Phát hiện rằng tỷ lệ hạch dương tính tăng và giai đoạn bệnh tiến xa liên quan với tử vong đặc hiệu do ung thư cao hơn là phù hợp với y văn hiện có về các yếu tố tiên lượng ung thư. Đặc biệt, giới nam và điều trị tại bệnh viện ngoài đô thị lớn nổi lên như các yếu tố có ý nghĩa, đặt ra cân nhắc về khác biệt sinh học tiềm ẩn cũng như chênh lệch trong khả năng tiếp cận hoặc chất lượng chăm sóc. Các trường hợp cắt bỏ không điển hình gợi ý sự biến thiên trong kỹ thuật phẫu thuật có thể ảnh hưởng đến kết cục.
Các hạn chế bao gồm thiết kế hồi cứu và việc phụ thuộc vào dữ liệu cơ sở đăng ký, có thể thiếu các chi tiết bệnh học hoặc phân tử ở mức độ sâu. Ngoài ra, xác thực ngoài dựa trên các đoàn hệ được tái dựng chứ không phải dữ liệu tiến cứu. Mặc dù có những giới hạn này, nghiên cứu đã đặt nền tảng cho việc ứng dụng phát hiện bất thường bằng machine learning vào phân kiểu lâm sàng cho các biến cố hiếm.
Kết luận
Nghiên cứu này chứng minh rằng các thuật toán phát hiện bất thường có khả năng diễn giải là một lựa chọn thay thế mạnh mẽ cho các mô hình sống còn kinh điển trong việc nhận diện các kiểu hình nguy cơ cao khó phát hiện ở u nguyên bào giả nhú đặc tụy đã được phẫu thuật cắt bỏ. Tỷ lệ hạch dương tính cao, giới nam, phương pháp cắt bỏ không điển hình, giai đoạn bệnh tiến xa và điều trị tại bệnh viện ngoài đô thị lớn xác định một phân nhóm nguy cơ cao có ý nghĩa lâm sàng, vốn bị che lấp bởi tỷ lệ biến cố thấp. Việc áp dụng các khung phân tích như vậy có thể hỗ trợ phân tầng nguy cơ cá thể hóa và định hướng chiến lược theo dõi ở các u hiếm, diễn tiến chậm. Các nghiên cứu xác thực tiến cứu tiếp theo và việc bổ sung các dấu ấn sinh học phân tử có thể nâng cao tính hữu ích của mô hình cũng như giá trị chuyển giao lâm sàng.
Tài trợ và ClinicalTrials.gov
Nghiên cứu được hỗ trợ bởi kinh phí nghiên cứu của cơ sở. Không có thử nghiệm lâm sàng nào được đăng ký liên quan đến phân tích này.
Tài liệu tham khảo
1. Papavramidis T, Papavramidis S. Solid pseudopapillary tumors of the pancreas: review of 718 patients reported in English literature. J Am Coll Surg. 2005;200(6):965-972.
2. Ricci C, Alberici L, et al. When survival models fail: An interpretable anomaly-detection approach for high-risk phenotypes in resected solid pseudopapillary tumors. Surgery. 2026;197:110381.
3. Lundberg SM, Lee SI. A unified approach to interpreting model predictions. Adv Neural Inf Process Syst. 2017;30:4765-4774.
4. Breunig MM, Kriegel HP, Ng RT, Sander J. LOF: identifying density-based local outliers. ACM SIGMOD. 2000;93-104.
5. Liu FT, Ting KM, Zhou Z-H. Isolation forest. 2008 Eighth IEEE International Conference on Data Mining. 2008:413-422.
