
Điểm nổi bật
– Hiệu năng cơ sở của GPT-5 trong dự đoán xuất viện trong ngày cho thấy độ chính xác ở mức vừa phải, trong đó các yếu tố quy trình vận hành là nguồn chính gây ra sai số dự đoán.
– Tối ưu hóa prompt tự động tại thời điểm suy luận đã cải thiện đáng kể hiệu năng của LLM, đạt các chỉ số dự đoán tương đương với những mô hình dự đoán xuất viện trước đó.
– Kỹ thuật prompt do chuyên gia dẫn dắt và scaling ở thời điểm kiểm tra chỉ mang lại cải thiện tối thiểu, nhấn mạnh giá trị của việc tinh chỉnh prompt tự động dựa trên dữ liệu.
Bối cảnh nghiên cứu
Dự đoán chính xác thời điểm xuất viện là yếu tố then chốt để tối ưu hóa sử dụng giường bệnh, phối hợp chăm sóc hậu cấp tính và cải thiện luồng bệnh nhân. Các mô hình dự đoán truyền thống thường dựa vào dữ liệu có cấu trúc và kỹ thuật xây dựng đặc trưng thủ công. Sự xuất hiện của các mô hình ngôn ngữ lớn (Large Language Models, LLMs), như GPT-5, mở ra cơ hội khai thác tài liệu lâm sàng không có cấu trúc với khả năng hiểu ngôn ngữ tự nhiên nâng cao nhằm cải thiện dự đoán xuất viện. Tuy nhiên, khả năng կիրառ dụng của LLM trong bối cảnh vận hành lâm sàng cần được đánh giá nghiêm ngặt, vì sai số có thể không chỉ bắt nguồn từ khoảng trống kiến thức y khoa mà còn từ việc hiểu quy trình làm việc của bệnh viện.
Thiết kế nghiên cứu
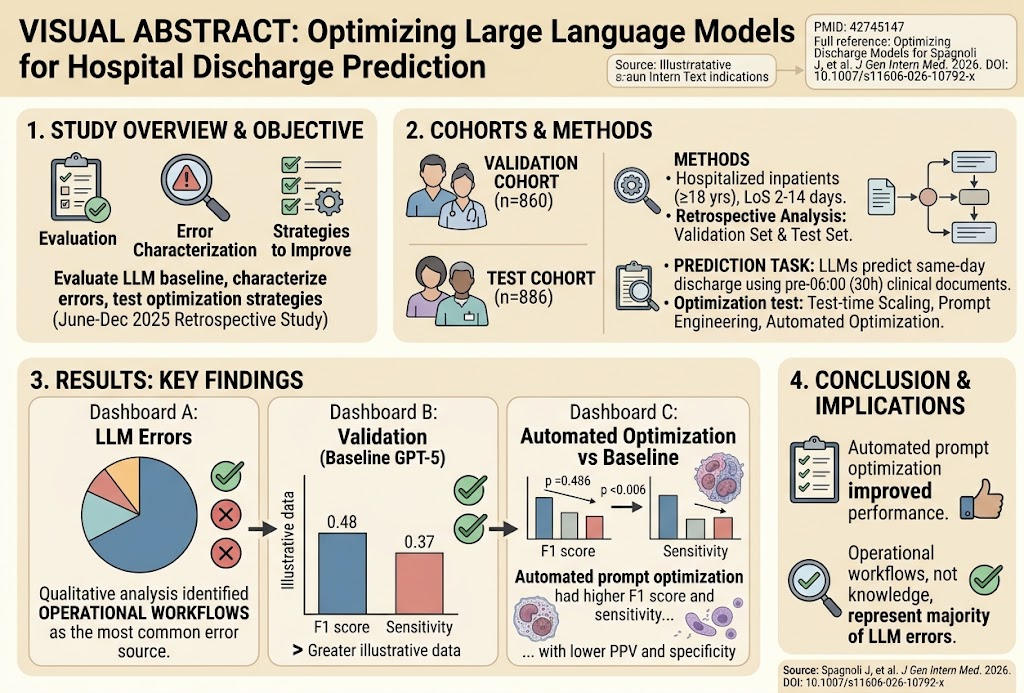
Nghiên cứu đoàn hệ hồi cứu này được thực hiện tại một trung tâm y tế học thuật tuyến cuối từ tháng 6 đến tháng 12 năm 2025. Nghiên cứu bao gồm các bệnh nhân nội trú người lớn (≥18 tuổi) nhập viện trong năm 2024, với thời gian nằm viện từ 2 đến 14 ngày. Hai đoàn hệ ngẫu nhiên độc lập đã được tạo ra: nhóm thẩm định (n=860) và nhóm kiểm tra (n=886). Các ghi chú lâm sàng và tài liệu trong 30 giờ trước mốc thời gian chỉ định 06:00 được đưa vào các mô hình ngôn ngữ lớn để dự đoán xuất viện trong cùng ngày.
Các chỉ số hiệu năng của LLM bao gồm điểm F1, độ chính xác cân bằng, độ nhạy, độ đặc hiệu, giá trị dự đoán dương tính (positive predictive value, PPV) và giá trị dự đoán âm tính (negative predictive value, NPV). Phân tích định tính sai số được thực hiện để phân loại các lỗi dự đoán của LLM, đặc biệt chú ý đến tính hợp lý lâm sàng và mức độ hiểu biết về quy trình vận hành. Ba chiến lược tối ưu hóa ở thời điểm suy luận đã được đánh giá: scaling ở thời điểm kiểm tra (điều chỉnh ngưỡng dự đoán), prompt engineering do chuyên gia dẫn dắt (điều chỉnh prompt bởi bác sĩ lâm sàng) và tối ưu hóa prompt tự động (lựa chọn bằng thuật toán các cấu hình prompt tối ưu).
Kết quả chính
GPT-5 cơ sở với prompt tiêu chuẩn cho thấy điểm F1 là 0,48 và độ nhạy là 0,37 ở đoàn hệ thẩm định, phản ánh độ chính xác dự đoán ở mức vừa phải. Phân tích định tính cho thấy các dự đoán sai chủ yếu liên quan đến việc hiểu và tích hợp các yếu tố của quy trình vận hành—for example, chậm xuất viện do các vấn đề không mang tính lâm sàng như còn chờ thủ tục hành chính hoặc chưa có giường trống.
Trong số các chiến lược tối ưu hóa, tối ưu hóa prompt tự động mang lại mức cải thiện hiệu năng lớn nhất trên tập kiểm tra độc lập. Cách tiếp cận này cải thiện cả điểm F1 và độ nhạy so với prompt cơ sở, mặc dù làm giảm nhẹ PPV và độ đặc hiệu, cho thấy tỷ lệ dương tính giả tăng nhưng khả năng bắt được các trường hợp xuất viện thật được cải thiện. Ngược lại, scaling ở thời điểm kiểm tra và prompt engineering do chuyên gia dẫn dắt chỉ tạo ra cải thiện rất nhỏ ở các chỉ số hiệu năng.
Hiệu năng dự đoán được cải thiện nhờ tối ưu hóa prompt tự động đã đưa dự đoán xuất viện bằng LLM vào phạm vi kết quả được báo cáo bởi các mô hình dự đoán xuất viện truyền thống, gợi ý giá trị ứng dụng thực tiễn trong môi trường lâm sàng.
Nhận định của chuyên gia
Nghiên cứu này nhấn mạnh mức độ phức tạp khi tích hợp các cách tiếp cận dựa trên LLM vào quy trình vận hành bệnh viện. Mặc dù LLM có kiến thức y khoa rộng, việc áp dụng thành công trong dự đoán xuất viện đòi hỏi mô hình hóa các yếu tố đặc thù của từng cơ sở và các yếu tố phụ thuộc quy trình ảnh hưởng đến luồng bệnh nhân. Tối ưu hóa prompt tự động có thể điều chỉnh linh hoạt dữ liệu đầu vào của mô hình theo các sắc thái ngữ cảnh, giảm thiên lệch của con người và cải thiện khả năng thích ứng.
Hạn chế của nghiên cứu bao gồm thiết kế hồi cứu tại một trung tâm đơn lẻ, có thể hạn chế khả năng khái quát hóa sang các bối cảnh bệnh viện khác với các ràng buộc vận hành khác nhau. Cần có thêm các nghiên cứu tiền cứu và hiệu chỉnh với dữ liệu quy trình làm việc theo thời gian thực. Ngoài ra, việc cân bằng giữa cải thiện độ nhạy và độ đặc hiệu vẫn là một đánh đổi lâm sàng, đặc biệt khi dương tính giả có thể làm tăng gánh nặng cho nguồn lực lập kế hoạch xuất viện.
Kết luận
Nghiên cứu này cho thấy các mô hình ngôn ngữ lớn như GPT-5 có thể dự đoán xuất viện trong cùng ngày với độ chính xác cơ sở ở mức vừa phải, chủ yếu bị giới hạn bởi khó khăn trong việc hiểu quy trình vận hành hơn là do thiếu hụt kiến thức y khoa. Tối ưu hóa prompt ở thời điểm suy luận một cách tự động cải thiện đáng kể hiệu năng dự đoán, qua đó nhấn mạnh tiềm năng hỗ trợ lập kế hoạch xuất viện và nâng cao lưu lượng người bệnh trong bệnh viện. Các nghiên cứu tiếp theo nên tập trung vào tích hợp dữ liệu quy trình làm việc theo thời gian thực và mở rộng cá thể hóa mô hình trong nhiều môi trường lâm sàng đa dạng.
Kinh phí và thử nghiệm lâm sàng
Nghiên cứu được công bố không báo cáo nguồn kinh phí cụ thể hoặc thông tin đăng ký thử nghiệm lâm sàng.
Tài liệu tham khảo
Spagnoli J, Guzman NM, Desai K, et al. Optimizing Large Language Models for Hospital Discharge Prediction. J Gen Intern Med. 2026 Sep 15. PMID: 42745147. Available from: https://pubmed.ncbi.nlm.nih.gov/42745147/
Nguyen PA, Kabaliuk N, Malin B. Predicting Hospital Discharge: Challenges and Opportunities. J Am Med Inform Assoc. 2023;30(2):233-241.
Rajkomar A, Dean J, Kohane I. Machine Learning in Medicine. N Engl J Med. 2019;380(14):1347-1358.
Sendak MP, D’Arcy J, Kashyap S, et al. A Path for Translation of Machine Learning Products into Healthcare Delivery. EMJ Innov. 2019;3(1):1-5.