
亮点
- 研究评估了基于规则的可计算表型与大语言模型(ChatGPT 4.1)在识别急诊科(ED)电子健康记录(EHR)中的阿片类物质使用障碍(Opioid Use Disorder, OUD)方面的表现。
- 两种方法均显示出较强的诊断准确性,阴性预测值较高,敏感度约为80%。
- 大语言模型的特异度和阳性预测值显著更高,提示其假阳性识别更少。
- 仍需在不同临床场景中开展前瞻性验证,以确认其泛化能力及其整合到ED工作流程中的潜力。
研究背景
阿片类物质使用障碍(Opioid Use Disorder, OUD)仍然是美国一项重大的公共卫生危机。阿片类药物误用相关的发病率和死亡率均较高,尤其是在急诊科场景中,许多患者因阿片类药物使用相关并发症而就诊。对ED中OUD患者进行准确识别,对于及时干预、启动治疗方案以及将患者转介至成瘾服务至关重要。然而,由于病历记录不一致、编码不足以及围绕物质使用诊断的污名化,基于电子健康记录(EHR)的识别较为复杂。 传统可计算表型——即利用诊断编码、处方药物、毒理学筛查和临床病程记录等结构化数据元素的基于规则算法——已被用于系统性识别OUD。尽管这类算法具有实用性,但由于规则较为僵化且数据获取不完整,仍可能漏诊或产生假阳性。 大语言模型(LLM),如ChatGPT,可利用自然语言处理和深度学习来解读非结构化临床文书。这些模型有潜力识别结构化编码无法捕捉的细微临床模式。本研究旨在比较:与经过验证的基于规则可计算表型相比,LLM是否能够增强对ED病程记录中OUD的识别能力。研究设计
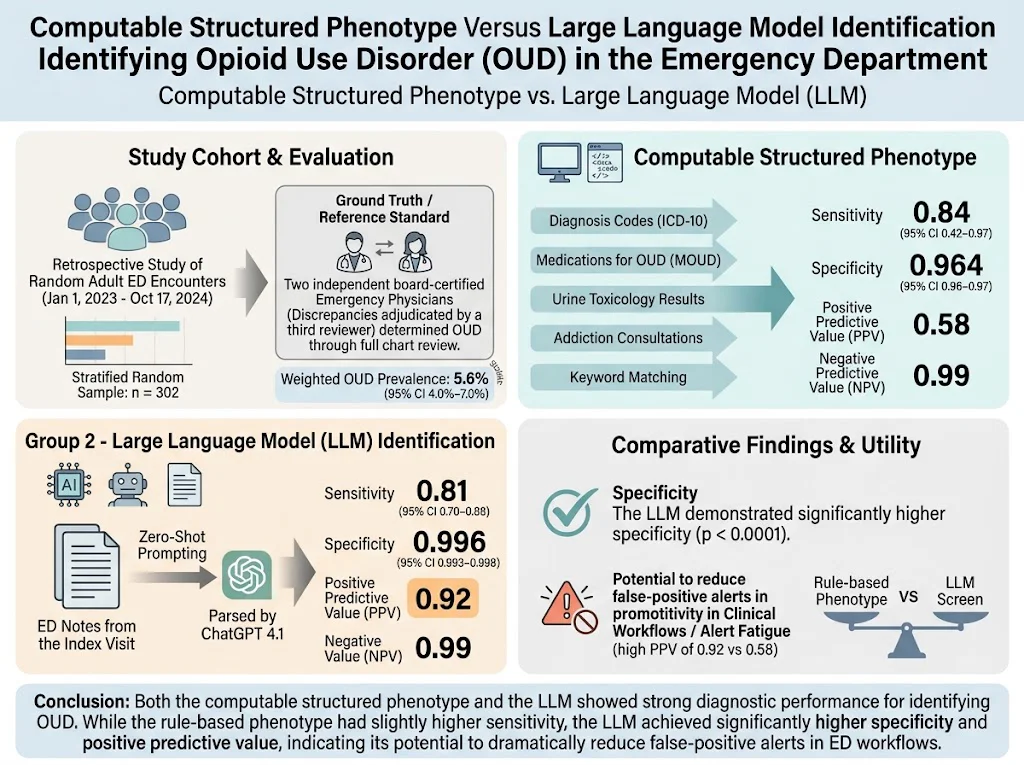
作者开展了一项单中心回顾性队列研究,纳入某学术医疗系统中2023年1月1日至2024年10月17日期间的成人ED就诊记录。研究根据既往由已建立的基于规则可计算表型对OUD进行分类的结果,采用分层随机抽样选取了302次就诊。该表型整合了多个结构化数据组成部分:ICD诊断编码、用于药物辅助治疗(medication-assisted treatment, MAT)的处方药物、尿液毒理学结果、成瘾医学会诊,以及临床记录中的关键词检索。 为进行比较,作者使用ChatGPT 4.1,并采用零样本提示(zero-shot prompting),通过分析首次就诊的非结构化ED病程记录来判定OUD状态。两名经委员会认证的急诊医师独立审阅完整病历作为参考标准,分歧由第三位审阅者裁定。 主要结局为:与专家病历审阅相比,表型和LLM的敏感度、特异度、阳性预测值(positive predictive value, PPV)及阴性预测值(negative predictive value, NPV)。研究采用基于抽样比例的逆概率加权法对患病率估计及性能指标进行调整。主要结果
加权后,样本人群中OUD的患病率约为5.6%(95% CI,4.0%~7.0%)。结构化可计算表型的敏感度为0.84(95% CI,0.42~0.97),特异度为0.964(95% CI,0.96~0.97)。其阳性预测值为0.58,处于中等水平;阴性预测值较高,为0.99。 相比之下,大语言模型(ChatGPT 4.1)的敏感度为0.81(95% CI,0.70~0.88),特异度显著更高,为0.996(95% CI,0.993~0.998)。这意味着其阳性预测值明显更高,达到0.92,同时仍保持0.99的阴性预测值。统计学检验证实,LLM的特异度显著优于表型(P < .0001)。 这些结果提示:虽然基于规则的表型可能捕捉到略多的真实病例(更高的敏感度),但其假阳性也更多,从而限制了PPV。相反,LLM更高的特异度可减少假阳性告警,这在急诊环境中尤为重要,因为告警疲劳可能干扰临床决策。专家评论
本研究是将人工智能用于临床环境中物质使用障碍识别的重要进展。结构化数据与先进自然语言处理技术的结合,为提升病例识别提供了有前景的路径。 不过,该研究也存在局限性,包括单中心设计以及对回顾性病历审阅的依赖,后者可能无法捕捉未记录的临床细节。所选队列中OUD患病率相对较低,也会影响预测值。此外,大语言模型的可解释性和透明度仍然是挑战,因此需要临床医生的信任及相应保障措施。 未来研究应重点关注在不同医疗系统和人群中的前瞻性验证。与临床工作流程的整合、对患者结局的影响以及成本效益分析,对于其实际应用转化至关重要。结论
基于规则的可计算表型和大语言模型两种方法,在基于急诊科电子健康记录识别阿片类物质使用障碍方面均表现出较强性能。结构化表型的敏感度略优,而大语言模型的特异度和阳性预测值更高,可能有助于减少假阳性告警并提升临床实用性。 将这两种方法结合使用,或先利用LLM进行初筛再用基于规则的方法进行确认,可能有助于优化准确性和工作流程效率。为有效利用这些工具应对持续存在的阿片类药物危机,仍需在真实世界环境中进一步验证和评估。资助与ClinicalTrials.gov注册
已发表研究未说明资助来源或临床试验注册号。未来研究可通过多机构合作及资金支持,促进更广泛的实施。参考文献
1. Molina MF, Fenton C, LeSaint KT, Pimentel SD, Kohn MA, Kornblith AE. Computable Structured Phenotype Versus Large Language Model Identification of Opioid Use Disorder Using Electronic Health Record Data. Ann Emerg Med. 2026 Jun 13;88(5):562-569. doi:10.1016/j.annemergmed.2026.03.010. PMID: 42287282. 2. Volkow ND, McLellan TA. Opioid Abuse in Chronic Pain — Misconceptions and Mitigation Strategies. N Engl J Med. 2016 Mar 31;374(13):1253-63. doi:10.1056/NEJMra1507771. 3. Beam AL, Kohane IS. Big Data and Machine Learning in Health Care. JAMA. 2018 Apr 3;319(13):1317-1318. doi:10.1001/jama.2017.18391. 4. Kharrazi H, et al. Data quality in electronic health records: a critical appraisal. Yearb Med Inform. 2017 Aug;26(01):127-132. doi:10.15265/IY-2017-015. 5. Rajkomar A, et al. Scalable and accurate deep learning for electronic health records. npj Digital Medicine 1, Article number: 18 (2018). doi:10.1038/s41746-018-0029-1. 6. Sarker A, et al. Machine learning and natural language processing for identifying opioid misuse in electronic health records: a systematic review. J Med Internet Res. 2020 Nov 11;22(11):e18585. doi:10.2196/18585.相关科室计算器
供临床参考,请结合专业判断使用。