要点提示
ChatGPT-4o 在重症医学专科委员会复习题中的总体正确率略高于临床医师汇总答案;但其图像解读和临床推理能力存在明显不足,在高风险场景中可能带来安全性与可靠性隐患。该模型在肺部与外科领域表现较强,但在重症超声图像解读方面结果较差。约三分之一的 AI 回答因错误而具有潜在临床危害风险。
相关科室计算器
供临床参考,请结合专业判断使用。
 By
No Comments
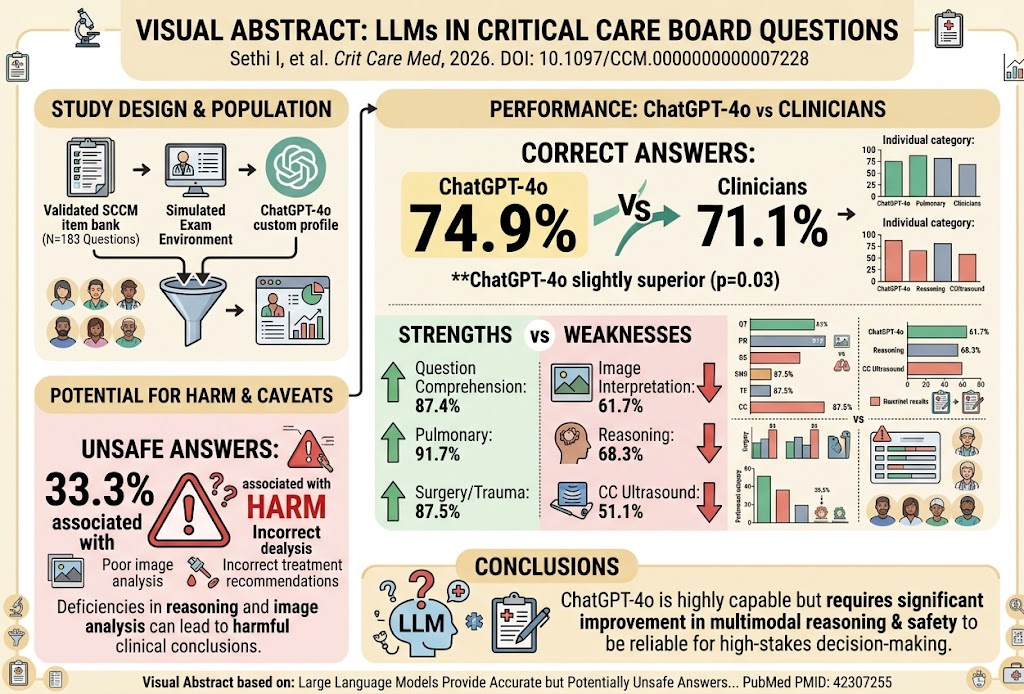
ChatGPT-4o 在重症医学专科委员会复习题中的总体正确率略高于临床医师汇总答案;但其图像解读和临床推理能力存在明显不足,在高风险场景中可能带来安全性与可靠性隐患。该模型在肺部与外科领域表现较强,但在重症超声图像解读方面结果较差。约三分之一的 AI 回答因错误而具有潜在临床危害风险。
供临床参考,请结合专业判断使用。
